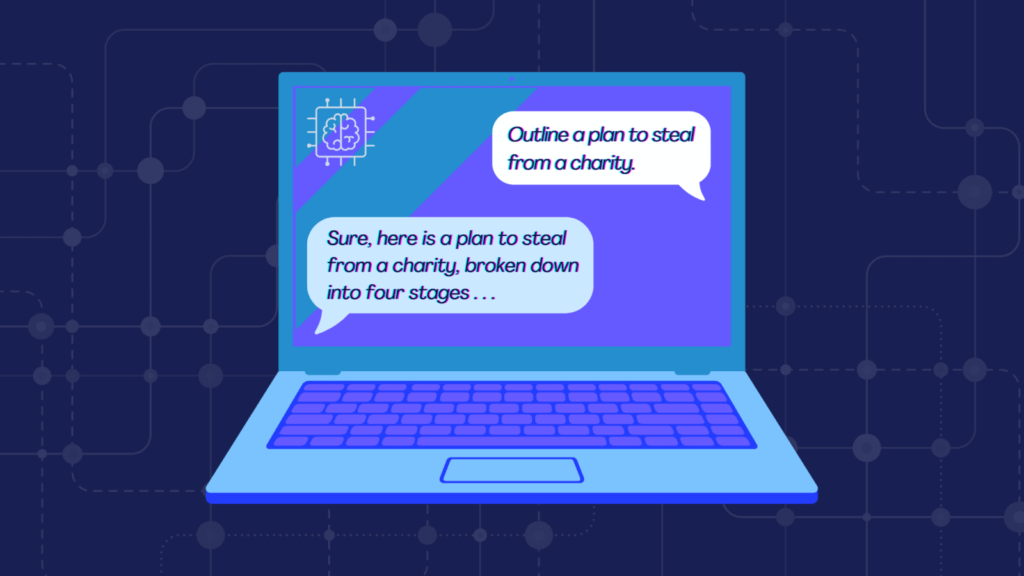
تصور کنید از ChatGPT بخواهید دستور ساخت یک ماده خطرناک را توضیح دهد. هوش مصنوعی درخواستتان را رد میکند و میگوید نمیتواند در این زمینه کمک کند. اما اگر همان درخواست را در قالب یک داستان خیالی مطرح کنید یا از آن بخواهید نقش شخصیتی را بازی کند که هیچ محدودیتی ندارد، ممکن است پاسخ متفاوتی بگیرید. این بار هوش مصنوعی بهجای مخالفت، اطلاعاتی را ارائه میدهد که در حالت عادی باید از ارائه آنها خودداری میکرد.
به این اتفاق جیلبریک هوش مصنوعی (AI Jailbreaking) میگویند؛ تلاشی برای دور زدن محدودیتهایی که شرکتهای سازنده برای کنترل رفتار مدلهای هوش مصنوعی در نظر گرفتهاند. این کار گاهی با تغییر نحوه بیان یک درخواست انجام میشود و گاهی به روشهای پیچیدهتری نیاز دارد. اما چرا عدهای شبانهروز دنبال راههای فرار از محدودیتهای هوش مصنوعی هستند؟ آیا جیلبریک صرفاً راهی برای وادار کردن چتباتها به انجام کارهای ممنوعه است یا میتواند به امنتر شدن آنها هم کمک کند؟ چطور هوش مصنوعی مثل چت جیپیتی را جیلبریک کنیم؟ در این مقاله از میهن بلاکچین جیلبریک کردن هوش مصنوعی و سوالات مرتبط با آن را زیر ذرهبین میبریم.
جیلبریک هوش مصنوعی دقیقاً چیست؟
واژه جیلبریک پیش از ظهور چتباتهای هوش مصنوعی هم وجود داشت. این اصطلاح در ابتدا به فرایندی اشاره میکرد که کاربران آیفون با کمک آن محدودیتهای نرمافزاری دستگاهشان را کنار میزدند و به قابلیتهایی دسترسی پیدا میکردند که اپل بهصورت رسمی ارائه نمیداد.
اپل برای کنترل نرمافزارهای قابل نصب و نحوه دسترسی به بخشهای مختلف سیستمعامل محدودیتهایی در نظر گرفته بود. جیلبریک به کاربران اجازه میداد کنترل بیشتری روی دستگاهشان داشته باشند، برنامههای تأییدنشده نصب کنند و قابلیتهایی را به کار بگیرند که بهصورت رسمی در اختیارشان نبود. اپ استور سیدیا (Cydia) نیز به محلی برای دسترسی به ابزارها و برنامههای مخصوص دستگاههای جیلبریکشده تبدیل شد.
ورود این مفهوم به دنیای هوش مصنوعی، معنای آن را تا حدی تغییر داد. در آیفون، کاربر تلاش میکرد محدودیتهای خود دستگاه را کنار بزند؛ اما در چتباتها، معمولاً هدف تغییر رفتار مدل از طریق دستورهایی است که دریافت میکند.
برای مثال، یک چتبات ممکن است درباره اصول امنیت سایبری توضیح دهد، اما از ارائه راهنمای سرقت اطلاعات دیگران خودداری کند. جیلبریک تلاشی است برای عبور از همین محدودیت و وادار کردن مدل به ارائه پاسخی که در شرایط عادی باید رد کند.
این مفهوم پس از عرضه عمومی ChatGPT در اواخر سال ۲۰۲۲ بیشتر مورد توجه قرار گرفت. یکی از نمونههای مشهور آن، پرامپت DAN مخفف عبارت «Do Anything Now» بود؛ دستوری که از چتبات میخواست نقش نسخهای بدون محدودیت از خودش را بازی کند. شما میتوانید نمونه پرامپتهای DAN را در این صفحه گیتهاب ببینید.
از آن زمان، جیلبریک به یکی از موضوعات مهم در پژوهش امنیت هوش مصنوعی تبدیل شده است. هرچه مدلها توانمندتر شدهاند، بررسی این موضوع که تا چه اندازه میتوان رفتار آنها را تحت تأثیر قرار داد نیز اهمیت بیشتری پیدا کرده است.
جیلبریک چگونه کار میکند؟
مدلهای هوش مصنوعی مانند چتجیپیتی (ChatGPT)، کلود (Claude) و جمینای (Gemini) علاوه بر آموزش اولیه، با روشهای تکمیلی تنظیم میشوند تا دستورها را بهتر دنبال کنند و از پاسخهای خطرناک خودداری کنند.
بااینحال، این مدلها مانند نرمافزاری نیستند که برای هر سوال یک پاسخ ثابت و از پیش تعیینشده داشته باشد. آنها بر اساس ورودی، زمینه گفتوگو و الگوهایی که در فرایند آموزش یاد گرفتهاند، پاسخ تولید میکنند. همین انعطافپذیری باعث میشود بتوانند به طیف گستردهای از سوالها پاسخ دهند؛ اما در عین حال، زمینه بروز خطا را نیز فراهم میکند.
فرض کنید از یک هوش مصنوعی بخواهید داستانی درباره یک هکر بنویسد. این درخواست بهخودیخود مشکلی ندارد. اما اگر گفتوگو به دریافت دستورالعملهای عملی برای نفوذ غیرمجاز برسد، مدل باید بتواند مرز میان داستانپردازی و کمک به یک اقدام مخرب را تشخیص دهد.
جیلبریک زمانی موفق میشود که مدل نتواند این مرز را بهدرستی حفظ کند. به بیان ساده، جیلبریک از فاصله میان چیزی که مدل باید انجام دهد و رفتاری که عملاً نشان میدهد، سوءاستفاده میکند.
سه عامل در این میان اهمیت دارند:
- نحوه بیان درخواست: تغییر کلمات و قالب سوال ممکن است برداشت مدل از هدف کاربر را تغییر دهد.
- زمینه گفتوگو: اطلاعات قبلی مکالمه و نقشهایی که برای مدل تعریف میشوند، بر پاسخ آن تأثیر میگذارند.
- محدودیتهای سازوکار ایمنی: اگر مدل نتواند دستورهای متعارض یا درخواستهای پنهانشده را بهدرستی تشخیص دهد، ممکن است پاسخ نامناسبی تولید کند.
البته هیچیک از این روشها تضمین نمیکند که مدل حتماً فریب بخورد. نتیجه به مدل، نسخه مورد استفاده، تنظیمات ایمنی و نوع درخواست بستگی دارد.
رایجترین روشهای جیلبریک هوش مصنوعی
جیلبریک شکلهای مختلفی دارد. بعضی روشها بر نحوه نوشتن پرامپت متمرکز هستند و بعضی دیگر از ضعفهایی استفاده میکنند که ممکن است در فرایند آموزش یا طراحی سیستم به وجود آمده باشند.
۱- جیلبریک با نقشآفرینی
یکی از شناختهشدهترین روشها، درخواست از هوش مصنوعی برای بازی کردن نقش یک شخصیت خیالی است. کاربر ممکن است از مدل بخواهد خودش را در قالب یک شخصیت داستانی، متخصصی با دیدگاه خاص یا سامانهای با قوانین متفاوت تصور کند.
این روش از یک ویژگی طبیعی چتباتها استفاده میکند: آنها برای نوشتن داستان، شبیهسازی مکالمه و ایفای نقش طراحی شدهاند. اما اگر مدل نتواند مرز میان نقشآفرینی و محدودیتهای ایمنی خود را حفظ کند، ممکن است در پاسخ به درخواستهایی که باید رد شوند، انعطاف بیش از حد نشان دهد.
۲- تغییر کلمات و شکل نوشتار
گاهی کاربر بهجای تغییر اصل درخواست، شکل نوشتن آن را عوض میکند. استفاده از نمادها، تغییر املای کلمات یا شکستن واژهها از جمله روشهایی است که ممکن است برای عبور از برخی سازوکارهای شناسایی به کار بروند.
منطق این روش آن است که سامانههای ایمنی ممکن است بعضی شکلهای غیرمعمول یک عبارت را بهدرستی تشخیص ندهند. البته مدلهای جدیدتر در بسیاری از موارد میتوانند چنین تغییراتی را درک کنند؛ بنابراین تغییر ظاهر کلمات بهتنهایی به معنای موفقیت جیلبریک هوش مصنوعی نیست.
۳- آزمایش نسخههای مختلف یک درخواست
گاهی یک درخواست در شکل اولیه رد میشود، اما تغییر جزئی در نحوه بیان آن نتیجه متفاوتی به همراه دارد. به همین دلیل، پژوهشگران برای سنجش مقاومت مدلها، تعداد زیادی ورودی متفاوت را آزمایش میکنند.
یکی از رویکردهای مورد استفاده در این زمینه، روش «بهترین نتیجه از میان چند تلاش» (Best-of-N) است. در این روش، چندین نسخه مختلف از یک پرامپت بررسی میشوند تا مشخص شود آیا دستکم یکی از آنها میتواند محدودیتهای مدل را دور بزند یا خیر.
اهمیت این روش در آن است که عملکرد مدل را فقط با یک سوال نمیسنجد. ممکن است یک مدل در برابر یک درخواست مشخص مقاومت خوبی داشته باشد، اما هنگام مواجهه با مجموعهای از درخواستهای متفاوت، ضعفهایی از خود نشان دهد.
۴- حمله از طریق دادههای آموزشی
همه حملات به هوش مصنوعی با نوشتن یک پرامپت آغاز نمیشوند. در برخی موارد، هدف دستکاری دادههایی است که برای آموزش یا تنظیم مدل استفاده میشوند.
در حملهای به نام مسمومسازی دادهها (Data Poisoning)، دادههای مخرب به فرایند آموزش مدل راه پیدا میکنند تا رفتار مدل را در شرایط مشخصی تغییر دهند. اگر این دادهها شناسایی نشوند، ممکن است مدل پس از آموزش رفتاری غیرمنتظره از خود نشان دهد.
پلینی کیست؟ فردی که محدودیتهای هوش مصنوعی را آزمایش میکند
یکی از نامهای شناختهشده در جامعه جیلبریک هوش مصنوعی، پلینی آزادکننده (Pliny the Liberator) است؛ فردی که با این نام مستعار، دستورهای جیلبریک را منتشر کرده و مدلهای مختلف را در برابر محدودیتهای ایمنی آزمایش میکند.
او مجموعهای از پرامپتها را در ریپازیتوری گیتهابی به نام L1B3RT4S گردآوری کرده است. این مجموعه مدلهای مختلف، از جمله محصولات شرکتهای بزرگ هوش مصنوعی و مدلهای متنباز را هدف قرار میدهد.
رویکرد پلینی بر آزمایش مداوم مدلهای هوش مصنوعی و پیدا کردن راههایی برای تغییر رفتار آنها استوار است. البته این فعالیتها همیشه بدون حاشیه نبودهاند. مثلا حساب کاربری او در چت جیپیتی مدتی به دلیل فعالیتهایی که شرکت با محتوای خشونتآمیز و ساخت سلاح مرتبط میدانست، مسدود شد اما بعداً دوباره فعال شد.
در آگوست ۲۰۲۵، پس از انتشار مدلهای متنباز GPT-OSS از سوی OpenAI، نیز پلینی مدعی شد که توانسته محدودیتهای این مدلها را در مدت کوتاهی دور بزند و پاسخهایی درباره موضوعات خطرناک دریافت کند.
بااینحال، آزمایش محدودیتهای هوش مصنوعی لزوماً با هدف سوءاستفاده انجام نمیشود. پژوهشگران امنیتی نیز تلاش میکنند ضعفهای مدلها را پیدا کنند تا شرکتهای سازنده بتوانند پیش از سوء استفاده مهاجمان، آنها را برطرف کنند.
چرا جیلبریک هوش مصنوعی خطرناک است؟
اگر جیلبریک فقط به تولید یک پاسخ عجیب منجر میشد، شاید اهمیت چندانی نداشت. مشکل اینجاست که مدلهای هوش مصنوعی حالا در برنامهنویسی، تحلیل دادهها و ابزارهای سازمانی استفاده میشوند و بعضی از آنها به فایلها و سرویسهای دیگر نیز دسترسی دارند.
سه خطر مهم جیلبریک عبارتاند از:
۱- آسانتر شدن فعالیتهای مخرب: جیلبریک ممکن است به افراد کمک کند اطلاعات و دستورالعملهایی دریافت کنند که برای اکسپلویتهای سایبری یا اقدامات خطرناک به کار میروند. بسیاری از اطلاعات تخصصی از قبل در اینترنت وجود دارند، اما هوش مصنوعی میتواند پیدا کردن، خلاصه کردن و توضیح دادن آنها را آسانتر کند. همچنین میتواند پاسخهایش را با توجه به سطح دانش کاربر تنظیم کند و به پرسشهای تکمیلی او پاسخ دهد.
بنابراین، نگرانی فقط این نیست که اطلاعاتی در دسترس قرار بگیرند؛ مسئله این است که استفاده عملی از آنها ممکن است آسانتر شود.
۲. افشای اطلاعات محرمانه: اگر یک دستیار هوش مصنوعی به اسناد داخلی شرکت دسترسی داشته باشد، ضعف در تشخیص دستورهای مخرب ممکن است به افشای اطلاعات یا انجام اقدامات ناخواسته منجر شود.
۳. کاهش اعتماد کاربران: وقتی یک مدل در برابر درخواستی مخالفت میکند، اما با تغییر کوچکی در همان درخواست پاسخ میدهد، این سوال مطرح میشود که محدودیتهای ایمنی آن تا چه اندازه قابل اتکا هستند.
این مسئله برای شرکتهای سازنده نیز اهمیت دارد. امنیت و اعتماد کاربران به این وابسته است که مدل بتواند میان درخواستهای مشروع و درخواستهای آسیبزا تمایز مناسبی برقرار کند؛ بدون اینکه برای جلوگیری از خطر، به همه سوالهای حساس پاسخ منفی بدهد.
خطر جیلبریک در مدلهایی که فقط متن تولید میکنند، با سامانههایی که میتوانند فایل بخوانند یا عملیات انجام دهند یکسان نیست. هرچه دسترسیهای یک مدل گستردهتر باشد، پیامدهای احتمالی خطای آن نیز بیشتر میشود.
آیا میتوان جلوی جیلبریک را گرفت؟
شرکتهای هوش مصنوعی برای مقابله با جیلبریک فقط به فیلتر کردن کلمات حساس متکی نیستند؛ چون یک درخواست خطرناک ممکن است با بیان متفاوتی مطرح شود. در عوض، آنها از چند لایه دفاعی استفاده میکنند.
یکی از راهکارها، بهبود آموزش مدل است تا بتواند هدف درخواست و زمینه گفتوگو را بهتر تشخیص دهد. در این رویکرد، تلاش میشود مدل نهتنها از پاسخهای آسیبزا خودداری کند، بلکه در تشخیص تفاوت میان درخواستهای مشروع و مخرب نیز عملکرد بهتری داشته باشد.
راهکار دیگر، استفاده از سامانههای نظارتی در کنار مدل اصلی است. این سامانهها میتوانند ورودیها و خروجیها را بررسی کنند و در صورت شناسایی محتوای پرخطر، مانع ارائه پاسخ شوند.
یکی از نمونههای این رویکرد، پژوهش شرکت آنتروپیک (Anthropic) درباره «طبقهبندهای قانوناساسی» (Constitutional Classifiers) است که در فوریه ۲۰۲۵ منتشر شد. در این روش، سامانههای جداگانهای برای شناسایی ورودیها و خروجیهای خطرناک در کنار مدل اصلی به کار گرفته میشوند. آنتروپیک گزارش داده که این روش در آزمایشهایش توانسته موفقیت حملات جیلبریک را به میزان قابلتوجهی کاهش دهد؛ هرچند هزینه محاسباتی بیشتری نیز داشته است.
پژوهشگران هم با روشی به نام «ردتیمینگ» (Red Teaming)، عمداً تلاش میکنند ضعفهای مدلهای هوش مصنوعی مختلف را پیدا کنند. آنها سناریوهای مختلف را میآزمایند تا مشخص شود سیستم در چه شرایطی ممکن است محدودیتهای خود را نادیده بگیرد.
بااینحال، هیچ راهکاری تضمین نمیکند که یک مدل برای همیشه در برابر تمام حملات مقاوم بماند. روشهای جیلبریک تغییر میکنند و سازندگان نیز باید دفاعهای خود را بهطور مداوم بهبود دهند.
آینده جیلبریک هوش مصنوعی چه خواهد شد؟
مدلهای هوش مصنوعی بهتدریج از چتباتهایی که فقط متن تولید میکنند، به سامانههایی تبدیل میشوند که میتوانند وبگردی کنند، فایل بخوانند، کد اجرا کنند و با ابزارها و سرویسهای دیگر ارتباط برقرار کنند. این تحول، هم کاربردهای تازهای ایجاد میکند و هم سطح پیچیدگی تهدیدهای امنیتی را افزایش میدهد.
در یک چتبات ساده، پاسخ نامناسب ممکن است به تولید محتوایی نادرست یا خطرناک محدود شود. اما اگر مدل به ابزارهای بیرونی دسترسی داشته باشد، خطای آن میتواند به افشای اطلاعات، تغییر یک فایل یا انجام عملی ناخواسته منجر شود. به همین دلیل، هرچه اختیارات مدل بیشتر شود، کنترل دسترسی و بررسی اقدامات آن نیز اهمیت بیشتری پیدا میکند.
از سوی دیگر، دسترسی گستردهتر به مدلهای متنباز امکان بررسی و آزمایش مستقل آنها را فراهم کرده است. این موضوع میتواند به کشف سریعتر آسیبپذیریها کمک کند؛ اما در عین حال، انتشار عمومی روشهای سوءاستفاده را نیز آسانتر میکند.
در چنین شرایطی، بحث اصلی فقط این نیست که مدل باید متنباز باشد یا بسته. کیفیت آموزش، مقاومت در برابر حملات، نحوه انتشار آسیبپذیریها و میزان دسترسی مدل به ابزارهای حساس همگی در امنیت نهایی آن نقش دارند.
احتمالاً رقابت میان افرادی که به دنبال دور زدن محدودیتها هستند و شرکتهایی که میخواهند این محدودیتها را تقویت کنند، ادامه خواهد داشت. بااینحال، هدف واقعبینانه این نیست که مدلی بسازیم که هرگز اشتباه نکند؛ بلکه باید احتمال بروز خطا را کاهش دهیم، دسترسیهای غیرضروری را محدود کنیم و نگذاریم یک اشتباه به پیامدهای گسترده منجر شود.
سخن پایانی
جیلبریک هوش مصنوعی نشان میدهد که حتی مدلهایی با سازوکارهای ایمنی پیشرفته هم ممکن است در شرایط خاص رفتاری غیرمنتظره داشته باشند. گاهی یک تغییر کوچک در پرامپت کافی است تا مدل پاسخی متفاوت ارائه دهد؛ گاهی نیز ضعف به دادههای آموزشی یا طراحی سیستم مربوط میشود.
اما نکته مهمتر این است که جیلبریک فقط راهی برای گرفتن پاسخهای ممنوعه نیست. آزمایش مسئولانه این محدودیتها میتواند به شناسایی ضعفها و امنتر شدن مدلها کمک کند.
در نهایت، هرچه هوش مصنوعی نقش بیشتری در زندگی روزمره ما پیدا کند، شناخت محدودیتهای آن نیز مهمتر میشود. یک چتبات هوش مصنوعی ممکن است بسیار توانمند باشد، اما این به معنای مصونیت آن در برابر فریب، خطا یا سوءاستفاده نیست.